LLM Wiki — 지식을 쌓아두는 방식
목차
Karpathy 가 4월에 올린 LLM Wiki 를 정리해둔다. LLM 이 위키를 직접 만들고 유지하게 하는 패턴이다.
취지, 구조, 실제 활용, 효율 순서로 본다. 효율 쪽이 제일 재미있다. 원문에 숫자가 한 개도 없어서.
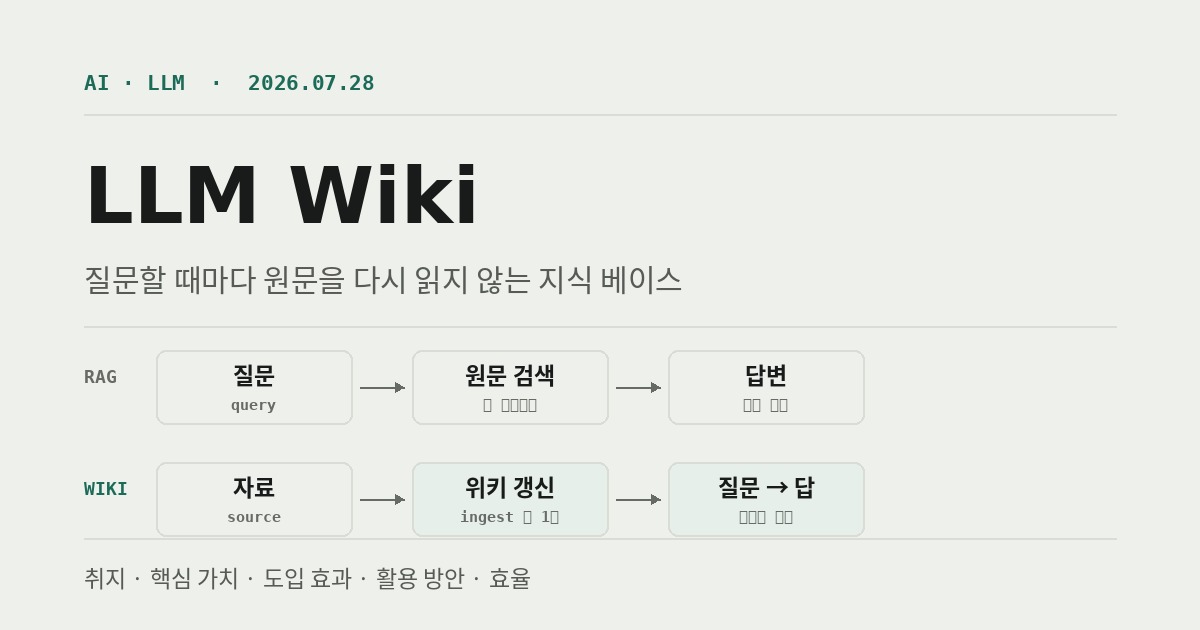
취지와 목적
원문은 X 게시물과 gist 두 곳에 있다. gist 쪽이 전문이라 인용은 여기서 한다.
문제 의식은 아래 문장에 있다.
This works, but the LLM is rediscovering knowledge from scratch on every question. There’s no accumulation. … NotebookLM, ChatGPT file uploads, and most RAG systems work this way.
논문 20편을 넣어두고 질문을 던지면 LLM 은 매번 그 20편을 처음 보는 것처럼 훑는다. 어제 한 추론이 오늘 남아있지 않다. 같은 자료로 같은 고민을 반복한다.
그래서 제안하는 방식은 아래와 같다.
Instead of just retrieving from raw documents at query time, the LLM incrementally builds and maintains a persistent wiki — a structured, interlinked collection of markdown files that sits between you and the raw sources.
원문이 직접 강조하는 문장은 이거다.
This is the key difference: the wiki is a persistent, compounding artifact.
쿼리 시점에 지식을 재구성하지 말고 ingest 시점에 컴파일해서 쌓아두자는 것.
참고로 gist 는 스스로를 이렇게 설명한다.
This document is intentionally abstract. It describes the idea, not a specific implementation.
구현물이 아니라 아이디어 문서다. 자기 에이전트에 복붙해서 쓰라고 적혀 있다.
3계층과 세 가지 연산
구조는 세 층이다.
| 계층 | 원문 정의 | 누가 쓰나 |
|---|---|---|
| raw sources | “immutable — the LLM reads from them but never modifies them. This is your source of truth.” | 아무도 안 고침 |
| the wiki | “The LLM owns this layer entirely. … You read it; the LLM writes it.” | LLM 이 씀, 사람은 읽음 |
| the schema | “a document (e.g. CLAUDE.md … or AGENTS.md)” | 사람이 정함 |
원문 표현이 좋다.
Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase.
연산은 세 개다.
Ingest. 새 자료를 읽고 위키에 반영한다. 원문은 “A single source might touch 10-15 wiki pages” 라고 적었다. 자료 하나가 페이지 하나로 가는게 아니고 여러 페이지에 흩어져 붙는다.
Query. 위키를 읽고 답한다. 좋은 답은 다시 위키에 새 페이지로 넣는다.
Lint. 모순, 낡은 서술, 고아 페이지, 빠진 상호참조를 점검한다. 위키를 유지하는 부분이 이거다.
보조로 index.md(카탈로그)와 log.md(시계열 기록)를 둔다.
사람 위키는 왜 망하나
원문이 일반 위키랑 비교하는 부분.
Humans abandon wikis because the maintenance burden grows faster than the value. LLMs don’t get bored… The wiki stays maintained because the cost of maintenance is near zero.
유지비가 0 에 가깝다는건 주장이다. 측정한건 없다. 뒤에서 다시 본다.
도입 후 효과
여기서부터는 조심해서 봐야 한다. 성격별로 나눠 적는다.
통제된 비교 실험 (딱 하나)
arXiv 2605.18490 (Theodore O. Cochran, 2026-05-18). 사전등록된 비교 실험이고 심사는 블라인드 LLM 이다.
- 규모: 논문 24편, 질문 13개. 답변 생성 모델은 양쪽 동일
- 위키가 나은 곳: 논문 간 연결·종합. 인용한 페이지가 주장을 실제로 뒷받침하는 비율
- RAG 가 나은 곳: 단일 사실 조회
- 비용: 초록 원문 그대로. “the wiki used far more query tokens than RAG, so it could not recover any upfront build cost through cheaper queries”
결론은 no architecture was best on all three 였다. 증거 조직화, 인용 지지, 비용 셋 다 이긴 쪽이 없다.
위키가 쿼리 토큰을 아낀다는 통설이 여기서 뒤집힌다. 다만 논문 24편 / 질문 13개면 작은 규모다.
자가 보고 사례
측정은 아니고 1인칭 후기다.
한 HN 사용자는 책 3권(약 15.5만 단어, 소스 파일 68개)을 넣어서 개념 페이지 210개,
상호참조 4,597개를 만들었다고 한다. 출력이 입력보다 많았다.
본인 표현으로는 It's not compression — it's synthesis.
두 책 사이에 명시되지 않은 모순을 찾아냈다는 얘기도 있다.
같은 사람이 더 중요한걸 적어뒀다. 소스를 어떻게 쪼개느냐가 결과를 갈랐다고.
책 한 권을 파일 하나로 넣은 순진한 버전은 결과가 엉망이었다. 챕터 단위로 쪼개니
changed the output categorically. Same model, same prompts — the only variable was source granularity 였다고 함.
반대 후기도 있다. 한 달 써보고 약 760페이지를 쌓은 사람은 유지에 쓴 시간과 아낀 시간이 비슷해서 본전이라고 했다. 자동 갱신이 안 되고 수동 팩트체크가 여전히 필요하다는 것.
숫자는 도는데 근거가 없는 것
- 대표 구현체 README 의
recall 58.2% → 71.4%. 방법론도 데이터셋도 없다. 게다가 LLM Wiki 대 RAG 비교도 아니고 자기 제품의 벡터검색 on/off 비교다 - 어떤 서비스는
10x better performance를 내걸었다. HN 에서 근거를 묻자 답이 없었다 - 토큰 비용 추정치를 낸 글이 하나 있는데 본인이
back-of-envelope라고 못박았다. 그 글에 이런 문장도 있다.nobody is publishing the real numbers
활용 방안
찾아본 사례는 성격이 꽤 다르다.
개인 아카이브를 지식 그래프로 쓰는 사례. 자기 블로그 글을 raw 로 두고 Obsidian 볼트를 LLM 이 유지한다.
소스 노트, 개념, 프로젝트, 맵으로 나눠 쌓는다. 그 글 결론이 인상적이었다.
위키 품질은 모델 성능만큼이나 AGENTS.md 같은 운영 문서 품질에 좌우된다고.
규제·법무 검토 사례. 이게 제일 독창적이었다. 계층을
raw/ → sources/ → drafts/ → review-drafts/ → context/ 로 늘리고,
사람이 승인한 context/ 만 AI 가 인용 근거로 쓸 수 있게 막았다.
과거 검토 사례는 유용하지만 위험하다고 봤다. 당시 서비스 구조, 계약 관계, 법령 버전이 다르니까.
그래서 힌트로만 쓰고 근거로는 안 쓴다.
기존 사내 저장소를 위키에 복제하지도 않는다. 그러면 SoT 가 둘이 되니까. lint 를 “AI 가 이 문서를 근거로 써도 되는지 확인하는 안전 게이트” 로 재정의한 것도 이 사례다. 그 글 정리 문장이 좋았다. LLM Wiki 에서 중요한건 ingest 자동화가 아니라 ingest 이후의 판단 권한 설계라는 것.
코드베이스·리서치 노트. 논문이나 저장소를 넣어두고 개념 단위로 정리하는 용도. 제일 흔한 형태다.
안 쓰는 게 나은 경우
- 문서가 수십만~수백만 건이면 기존 검색·벡터DB
- 실시간성이 필요하면 API + RAG
- 조항 번호를 정확히 맞춰야 하면 전문검색
- 원본 불변이 필수인 법무·감사면 DMS
원문도 규모 한계를 인정한다. index.md 방식은 소스 ~100개, 페이지 수백 개 수준에서 잘 돌아가고
그 위로는 검색엔진을 붙이라고 적혀 있다.
Karpathy 본인이 일정 규모 위에서는 RAG 적 요소를 다시 붙이라고 쓴 거다.
RAG 를 대체한다는 프레이밍은 원문이 지지하지 않는다.
효율
| 주장 | 근거 |
|---|---|
| 유지 비용이 0 에 가깝다 | 원문 주장. 측정 없음 |
| 쿼리 토큰을 아낀다 | 유일한 통제 실험에서 반대 결과 |
| recall 58.2% → 71.4% | 자사 기능 on/off 비교. 방법론 없음 |
| 10x 빠르다 | 근거 미제시 |
| 논문 간 종합에 강하다 | arXiv 2605.18490 에서 확인됨 |
| 인용이 주장을 잘 뒷받침한다 | 같은 실험에서 확인됨 |
효율 보고 도입하면 어긋날 수 있다. 실제로 확인된 이득은 종합 능력과 인용 신뢰도 쪽이다. 비용은 오히려 늘 수 있다.
ingest 때 한 번 크게 쓰고 쿼리를 싸게 가져간다는 그림이 직관적이긴 하다. 근데 그 직관을 검증한 유일한 실험에선 결과가 반대로 나왔다.
비판
HN 스레드에 날 선 지적이 많다.
그냥 RAG 아니냐는 지적. This is just RAG. Yes, it's not using a vector database - but it's building an index file of semantic connections… this is RAG. 반론은 쓰기 루프가 다르다는 것.
바닐라 RAG 는 코퍼스가 고정인데 여기선 LLM 이 코퍼스를 직접 쓰고 고친다.
사고의 외주화. 제일 많이 나온 비판이다.
Most of the value of writing docs or a wiki is not in the final artifacts, it's that the process of writing docs updates your own mental models. 위키를 만드는 과정에서 생기는
이해를 통째로 넘기는게 맞냐는 것.
제일 솔직한 증언은 이거였다.
I miss thinking harder… But the wiki workflow is just too addictive to stop.
2차 정보의 오차 누적. 원문 대신 위키를 읽으면 미묘한 오류가 쌓인다는 지적. 환각이 위키에 고착되면 직접 물었을 때는 맞게 답하던 것도 틀리게 된다.
검수 부담. I'd rather have it source the original document everytime, then an LLM-generated wiki which I most likely wouldn't have the time to fact-check and review myself.
lint 의 확장성. 모순을 찾으려면 N개 파일에 N×N 비교가 필요하다.
임계점. 어느 지점을 넘으면 에이전트도 위키를 못 따라가고 사람도 파악을 못 한다는 것.
구현체
| 저장소 | Stars | 언어 | 라이선스 |
|---|---|---|---|
| nashsu/llm_wiki | 15,404 | TypeScript | GPL-3.0 |
| AgriciDaniel/claude-obsidian | 9,993 | Python | — |
| Astro-Han/karpathy-llm-wiki | 1,647 | Python | — |
| lucasastorian/llmwiki | 1,425 | Python | — |
Stars 는 2026-07-28 조회 기준.
제일 큰 nashsu/llm_wiki 는 Tauri v2 + React 19 데스크톱 앱이다.
macOS·Windows·Linux 바이너리가 있고 OpenAI, Anthropic, Google, Ollama 를 붙일 수 있다.
로컬 실행이 되고 MCP 서버도 들어있다.
원본의 3계층과 ingest/query/lint, index.md, [[wikilink]], Obsidian 볼트 호환은 그대로 두고
지식그래프, 커뮤니티 탐지, 웹클리퍼 같은걸 얹었다.
라이선스가 GitHub 에서 NOASSERTION 으로 뜬다. LICENSE 파일을 열어보면 표준 GPLv3 전문이다.
맨 앞에 저작권 한 줄이 붙어서 자동 판별기가 인식을 못 한 것 같다.
다만 위에서 본 실제 사용 사례들은 대부분 이런 앱 안 쓰고 gist 보고 폴더를 직접 만들어 쓴다.
쓸 거면
아이디어 자체는 단단하다. 매번 원문을 다시 읽는 대신 컴파일해서 쌓아두자는 것. 사람이 못 하던 위키 유지를 LLM 에 맡기자는 것.
원문이 Memex 를 직접 언급한다. 1945년에 나온 아이디어인데
The part he couldn't solve was who does the maintenance. The LLM handles that. 라고 적었다.
근데 효율을 근거로 도입을 결정하면 안 될 것 같다. 검증된 이득은 종합과 인용 신뢰도다. 비용은 유일한 실험에서 오히려 불리하게 나왔다. 한 달 써본 사람 평가가 본전이었던 것도 같은 맥락인듯.
도입한다면 규모를 작게 잡고(소스 100개 아래), 소스를 잘게 쪼개고, 위키를 원문처럼 믿지 않는 선에서 시작하는게 맞을 것 같다. 규제 사례처럼 어떤 문서를 근거로 인정할지 를 사람이 쥐고 있는 구조면 더 낫고.
참고
- Karpathy gist (전문) — https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
- 원본 X 게시물 — https://x.com/karpathy/status/2039805659525644595
- HN 토론 — https://news.ycombinator.com/item?id=47640875
- 사전등록 비교 실험 — https://arxiv.org/abs/2605.18490
- nashsu/llm_wiki — https://github.com/nashsu/llm_wiki
- 한국어 소개 — https://discuss.pytorch.kr/t/llm-wiki-feat-karpathy-llm-wiki/10139